Боты и SEO: поведенческие факторы, краулеры, парсинг
Накрутка поведенческих факторов, агрессивные краулеры и парсеры влияют на позиции и нагрузку сайта. Рассказываем, как отличить их от живых посетителей и полезных поисковых роботов.
Фасетная навигация и поисковые роботы: как настроить фильтры интернет-магазина без бот-петель
Неправильно настроенные фильтры превращают каталог в лабиринт для роботов, вызывая блокировку индексации и потерю трафика. Мы покажем инженерный подход к разрыву циклов и формированию чистого графа переходов для поисковых систем.
Каннибализация бюджета сканирования: как технический мусор мешает индексации новых статей
Технический мусор на сайте перекрывает доступ поисковых роботов к новым материалам, вызывая прямые убытки в трафике и доходах. Мы покажем, как математически оценить потери и инженерно очистить структуру для восстановления скорости индексации.
Как поисковики выявляют накрутку поведенческих факторов: алгоритмы Яндекса против ферм
Мы анализируем механику обнаружения ботов через отклонение метрик от эталонных нормативов и выявляем уязвимости в логике ферм. Практическое руководство по защите репутации сайта от санкций поисковой системы.
Влияние бот-трафика на позиции в Яндексе и Google: разбор мифов и реальных алгоритмов
Экспертный материал по теме «Влияние бот-трафика на позиции в Яндексе и Google: разбор мифов и реальных алгоритмов»: детальный инженерный анализ, расчеты и практические нюансы.
Полезные и вредные роботы поисковиков: как грамотно настроить краулинговый бюджет
Мы перестали гадать о лимитах запросов и начали считать их как инженерные ресурсы, что сократило время выхода новых страниц в топ с недель до дней. Эта инструкция покажет, как распределить ползание роботов так, чтобы каждый запрос приносил конверсию, а не просто занимал место в очереди.
SEO-атака на сайт: как быстро распознать массовый нагон ботов и минимизировать ущерб
Мы превратили мониторинг аномального трафика из рутинной задачи в автоматический триггер срабатывания защиты. Этот гайд показывает, как математически доказать факт атаки и отсечь 99.8% ботов без потери конверсии.
Индексация мусорных страниц ботами: как закрыть уязвимости внутреннего поиска сайта
Внутренний поиск часто становится каналом для парсинга мусорных страниц, что истощает бюджет на рекламу и портит поведенческие метрики. Мы показываем, как технически отсечь сканеров, сохранив доступ для живых пользователей и легальных партнеров.
ИИ-краулеры (AI Bots): как заблокировать ChatGPT, Claude и Gemini от парсинга контента
Мы сталкиваемся с массовым парсингом контента моделями LLM, что требует перехода от простой фильтрации IP к анализу семантических паттернов запросов. Данная инструкция дает алгоритм блокировки популярных ИИ-краулеров без ущерба для легальных пользователей.
Парсинг сайта конкурентами: как автоматический сбор данных убивает уникальность и позиции
Автоматизированный сбор данных конкурентами создает токсичные дубли страниц, которые поисковые роботы трактуют как спам, мгновенно обнуляя фактор авторитетности. Мы покажем, как математически рассчитать лимиты запросов и внедрить защиту, чтобы сохранить индексацию и органический трафик.
Накрутка поведенческих факторов конкурентами: как распознать атаку и защитить позиции
Конкуренты используют ботов для искусственного завышения метрик вовлечения, что искажает реальную картину эффективности сайта. Мы покажем алгоритм детектирования аномалий и методы блокировки атак на уровне сервера и аналитики.
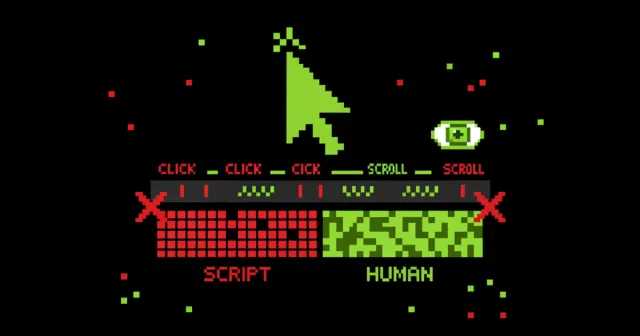
Вебвизор показывает странное поведение: как по записи отличить человека от скрипта
Разбираем визуальные маркеры в записях сессий: как по движениям курсора, кликам и прокрутке отличить реального посетителя от автоматического скрипта.
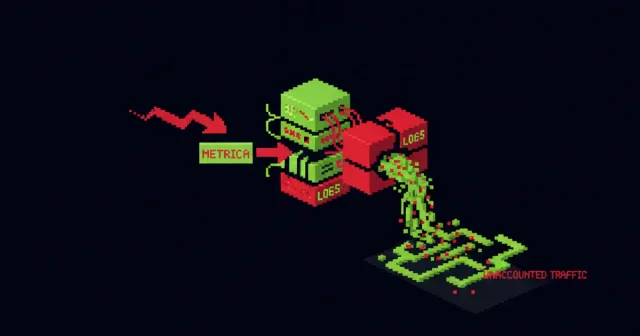
Расхождение данных Метрики и логов сервера: где прячется неучтенный трафик
Разбираем технические причины расхождения данных Метрики и логов сервера. Узнайте, почему цифры хостинга выше отчетов аналитики и где прячется неучтенный трафик.
Парсинг сайта конкурентами как автоматический сбор данных убивает уникальность текстов
Разбираем механику промышленного парсинга контента, методы выявления автоматических сборщиков данных и способы защиты позиций сайта в поисковых системах.